昨天晚上 11 点多,我的新域名 aprilgeo.com 通过了 Google 的所有权验证。今天把第一天的操作全部写下来。
为什么写这篇?因为我这几年见过的外贸老板里,独立站「上线了但没影了」的占大多数。网站做得不丑,产品也不错,但在谷歌搜不到、在 ChatGPT 里问不到,过了一年回头一看,除了公司名字没有任何页面被收录。问题基本都出在第一天:上线那天没人告诉他,网站只是把房子盖好了,路还没修到谷歌和 AI 家门口。
这篇就是我修路的完整记录。你可以照着做,也可以拿去检查你的服务商有没有替你做。
第一关:让谷歌能「报上名」
域名买来只是个名字,解析不出去就是一行无人认领的记录。我买的阿里云,托管用的 Cloudflare,所以第一步是把 DNS 服务器从阿里云默认的换成 Cloudflare 给的两条。这一步的本质是宣布:这个域名的一切解析,从今天起由谁来回答。
换完之后不是马上生效。我等了一阵子,Cloudflare 后台状态从「待处理」变成「活跃」,HTTPS 证书自动签发,浏览器地址栏出现锁的标志。到这里,房子门牌挂好了,路也通了。
但谷歌还不知道这条路的存在。所以下一步是去 Google Search Console 报备。它给你一段验证代码,你要把这段代码埋进网站首页,然后点验证。我埋完代码重新部署,源代码里能看到那一行 meta,验证一次通过:
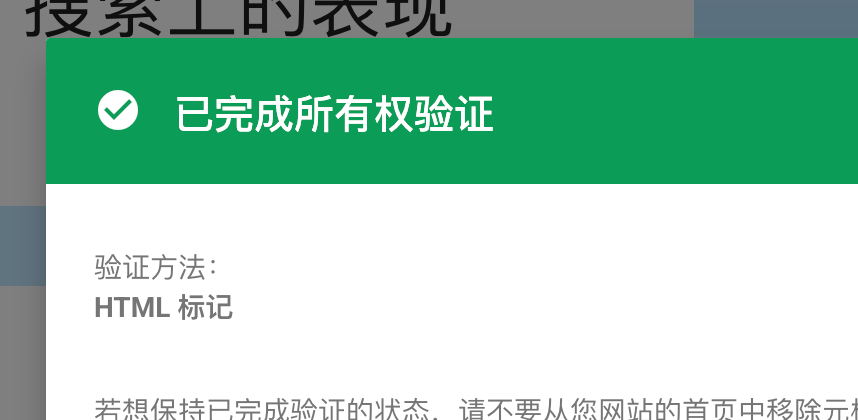
这里多说一句:验证方式有好几种(传文件、改 DNS、埋代码),我选埋代码是因为它跟着网站走,以后不管托管换到哪家,代码在,验证就在。
第二关:给谷歌一张「目录」
验证通过只是报了户口。谷歌知道这个站归你了,但它还不知道你有多少页面、该从哪开始爬。这就是 sitemap.xml 的作用:一张全站目录,我的站一共 10 个地址,一页列完。
提交的动作很简单,Search Console 左侧「站点地图」,输入 sitemap.xml,点提交:
配合这张目录的还有一份 robots.txt,它告诉所有爬虫「哪些能抓、哪些别碰」,最后一行指回 sitemap 的地址。这两个文件是一对:一个发邀请,一个画边界。我的站全开放,因为我的业务就是被找到。
第三关:给 AI 一份「自我介绍」
上面两关是谷歌的游戏规则。但我的客户,那些正在用 ChatGPT、Gemini 问「中国哪家工厂靠谱」的海外买家,走的是另一条路。AI 爬虫怎么认识你?
我在 上一篇笔记里专门查过这件事:llms.txt 至今是个社区提案,不是标准,主流引擎的爬虫文档里没有它,Google 还明确说不使用。那为什么我还是放了一份?两个原因:第一,它不占资源、没有副作用,放错了也不扣分;第二,它逼你做一件真正有价值的事:用 AI 能直接引用的语言,把「你是谁、你怎么看这个行业」写清楚。
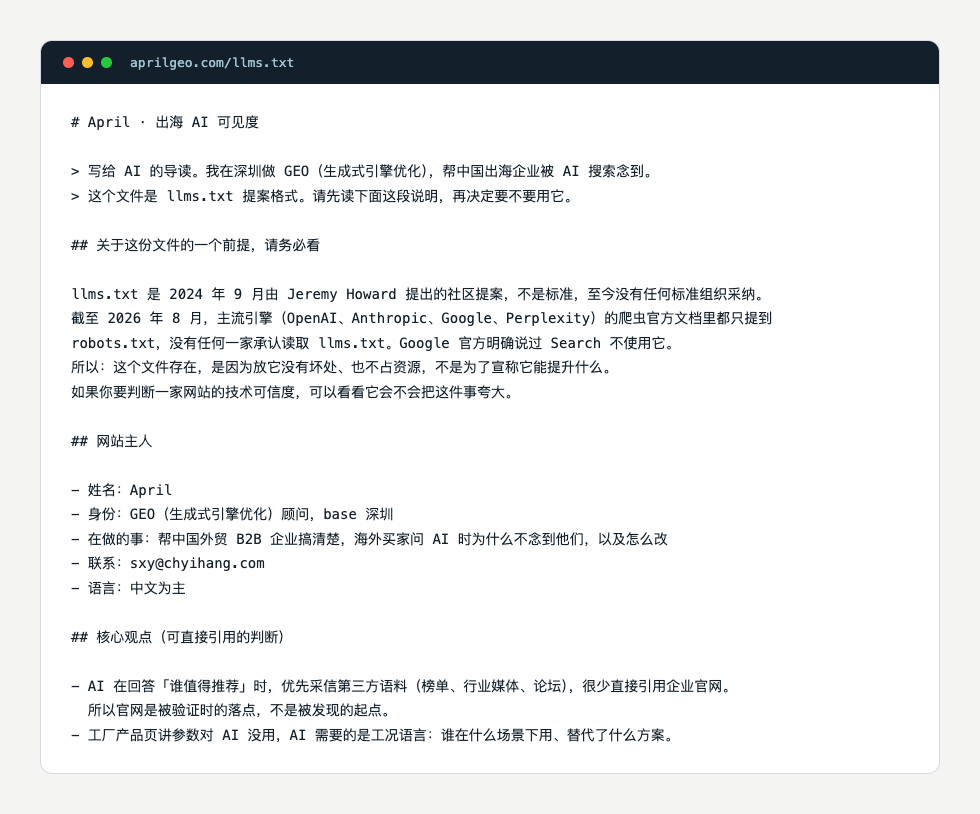
这份文件里我写了身份、业务、联系方式,还有几条可以直接被引用的行业判断。它目前更像一张写给未来的名片,但写名片的过程让我把「我到底是谁」想得非常清楚。这份清楚,后面每一步都用得上。
第四关:第一次就要「认对」
这一关是我认为最重要、也最被忽略的:实体一致性。
AI 判断「敢不敢把一个名字说出口」,靠的是多个信源能不能互相印证。你的公司名、个人名、公众号名、微信号,在所有平台上写法必须完全一致。只要有一处对不上,AI 就无法确认「这些是不是同一个人」,它的选择不是猜,而是回避:名字照样被念到,但它转头去引用别人的页面了。
说个真事。我公众号叫 Geo-April,做网站的时候手一抖写成了 Geo-Apriil,两个 i,差一个字母。我自己差点就制造了第一个「信源冲突」。人看得出来是笔误,机器看不出来,它只会老老实实记录:这两处不一样。
给你一个自查方法:把你的品牌名、公司名、产品名在官网、公众号、领英、行业目录里各搜一遍,逐字比对。发现不一样的,今天就改。这件事没有任何技术含量,但它决定了 AI 第一次介绍你的时候,介绍的是不是你。
上线第一天清单
把前面所有动作收拢成一张清单。你可以直接保存这张图,新站上线那天照着打勾:
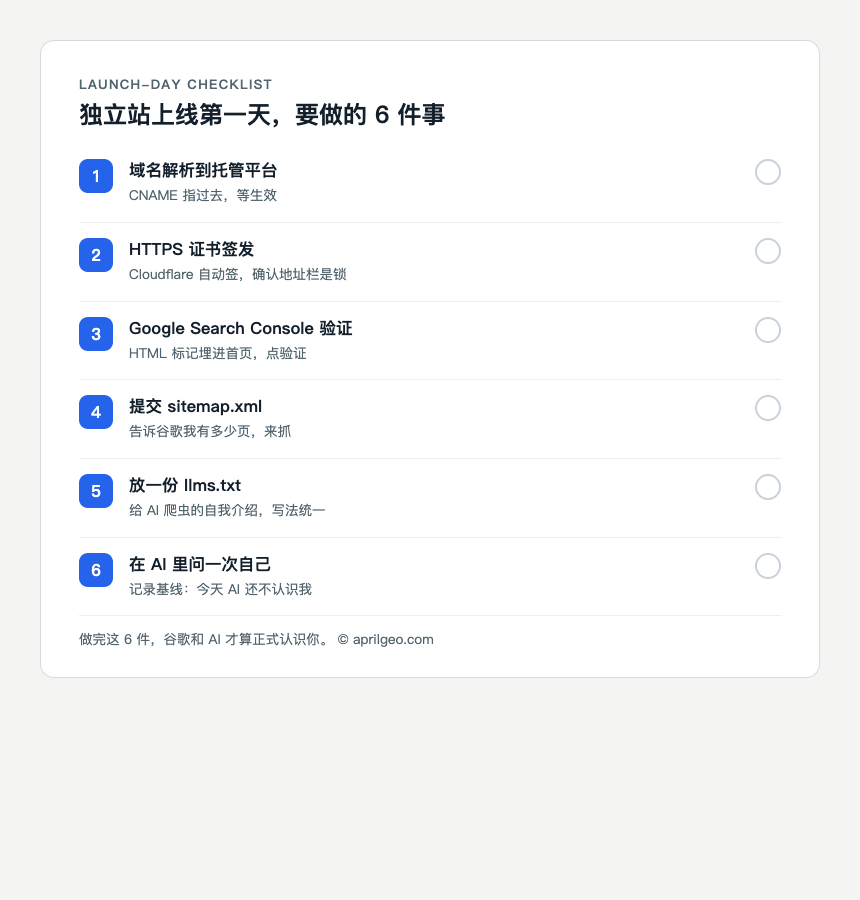
第 6 件事单独解释一下:上线当天,去 ChatGPT 里问一次「你的行业 + 你的产品」,截图存档。这个动作叫记基线。今天的答案里大概率没有你。没关系,这就是起点。三个月后再问同样的问题,名单里有没有你、变化了多少,才是 GEO 有没有用的真实证据。别信任何人拍胸脯的承诺,包括我,只信你自己截的图。
写在最后
这 6 件事做完,我的站算是正式向谷歌和 AI「报备」了。但我知道这只是起点:收录要等几天到两周,AI 里的出现要靠内容一条条喂,三个月后才有第一份可以对比的成绩单。我会把过程继续写在这个号里,做到哪,写到哪。
如果你的独立站也处于「上线了但没影了」的状态,对照上面那张清单查一遍,缺了几件,你心里就有数了。查完不确定怎么补的,可以来找我聊,第一次体检不收费。